La superintelligence artificielle (AGI voire ASI), cette super-Arlésienne du début de notre ère IA

« Welcome to the AGI era », a lancé Greg Brockman, président co-fondateur d’OpenAI en annonçant le 3 septembre 2026 le modèle d’IA baptisé Astra. « AGI has arrived », l’a félicité Jensen Huang, PDG de Nvidia qui lui fournit le matériel de calcul (GPU). Mensonges. Car l’AGI n’est pas encore là.
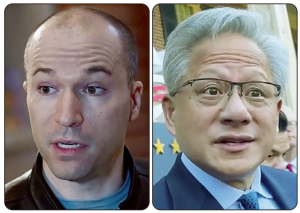
Les deux papes de l’intelligence artificielle, Greg Brockman (photo de gauche), président co-fondateur d’OpenAI, et Jensen Huang (photo de droite), PDG de Nvidia, veulent nous faire prendre des vessies pour des lanternes. L’un et l’autre veulent, nous faire croire – à nous les Humains – que la super-IA générale désignée par AGI (Artificial General Intelligence), voire ASI (Artificial Superintelligence), est arrivée. Qui plus est avec le modèle GPT-6 Astra lancé le 3 septembre 2026 par OpenAI, près de quatre ans après avoir défrayé la chronique avec le coup d’envoi de la pionnière des IA génératives, ChatGPT.

Pour OpenAI et Nvidia, l’AGI est déjà là
Lors de la présentation de GPT-6 Astra, Greg Brockman a affirmé que lorsqu’à l’avenir nous regarderons en arrière, nous diront que « l’AGI fut créée à peu près à cette époque, et je pense que cela pourrait concerner ce modèle ». En assurant même : « Pour moi, personnellement, je pense que nous y sommes ». OpenAI qualifie même son dernier modèle en date de « modèle le plus intelligent et aligné au monde ». Et le PDG de du géant Nvidia, numéro un mondial des cartes graphiques (GPU) nécessaires à la puissance de calcul des IA génératives et premier fournisseur d’OpenAI, ne s’est pas privé de porter au pinacle le nouveau modèle de son très gros client, dont il détient en plus environ 3,5 % du capital : « L’AGI est arrivée. Félicitations @OpenAI team », étant entendu que GPT-6 Astra est entraîné sur la plateforme « Grace Blackwell NVLink72 » de Nvidia dotée actuellement de plus de 100.000 GPU et « prochainement » de 400.000 GPU (1).
Pour apporter de l’eau au moulin des deux dirigeants débordant d’enthousiasme, Greg Kamradt, président de la ARC Prize Foundation, une organisation californienne à but non lucratif dédiée à la création de benchmarks pour AGI – ou intelligence artificielle générale (IAG) en français – a (suite)
La « tokénisation » de l’économie est en marche : les jetons IA deviennent des unités de facturation

Un token – ou jeton en français – est l’unité de texte que traite les modèles d’IA générative. Il s’agit d’un morceau : mot entier, syllabe, caractère, ponctuation ou espace. Il est aussi devenu une unité de facturation dans l’économie agentique mondiale. Bienvenue dans la « token economy ».

Le terme « token » (ou « jeton » en français) dans le domaine de l’intelligence artificielle (IA) est bien antérieur à l’essor des grands modèles de langage (LLM) actuels. Il provient de la linguistique, de la logique formelle et de l’informatique (compilateurs, traitement du langage naturel, ou NLP pour Natural Language Processing). En mars 2026, Jensen Huang (photo), le PDG de Nvidia, a redéfini le centre de données comme étant désormais « une usine qui produit des jetons intelligents d’IA » (1). Et ces tokens sont devenus des unités de facturation dans la nouvelle économie agentique mondiale.

Les « tokéniseurs » sont à l’œuvre
Encore faut-il prémâcher le travail pour les IA génératives, qui ne sont pas si intelligentes que ça. Pour ce travail en amont indispensable à l’économie agentique, il y a les « tokenizer » (tokéniseur) – que l’on pourrait traduire en français par « segmentateurs de texte » ou « découpeurs de texte ». Bref, l’inverse de la concaténation qui consiste au contraire à recoller les bouts. La tokénisation est la face cachée des IA et le tokéniseur est l’outil qui découpe le texte en petites unités appelées jetons – les tokens. Ces jetons sont ensuite transformés en chiffres que le modèle d’IA peut comprendre car celle-ci ne lit pas les mots comme l’humain, loin de là, mais ne « voit » que des suites de nombres (des identifiants de tokens). En tant qu’algorithme qui découpe le texte brut (le prompt par exemple) en petits morceaux, le tokéniseur fait donc la traduction du texte humain en jetons, lesquels deviennent des nombres exploitables. Et quand l’IA générative répond à l’utilisateur (phase d’inférence), le processus est inversé. Les tokéniseurs sont (suite)

Société civile des auteurs multimédia (Scam), 45 ans : des perceptions 2025 record… sans l’IA

La Scam a collecté en 2025 un montant à nouveau record au titre des droits d’auteur (+ 2,6 %), à près de 128 millions d’euros. Du jamais vu depuis la création en 1981 de cet organisme de gestion collective. Près de 70 % viennent de l’audiovisuel. Le numérique accélère : en attendant les IA génératives.

« La Scam prend à bras-le-corps le tournant majeur qu’est l’émergence de l’intelligence artificielle (IA) dans nos métiers : dans le secteur audiovisuel notamment, à son initiative, auteurices et producteurices disposent désormais de clauses types sur l’utilisation de l’IA à intégrer dans les contrats », ont assuré la présidente, Anja Unger, et le directeur général, Hervé Rony (photo), de la Société civile des auteurs multimédia (Scam), dans leur éditorial d’introduction du rapport d’activité 2025, lequel a été approuvé le 17 juin par l’assemblée générale de cette organisation de gestion collective (OGC) des droits d’auteurs.
IA : la Scam menace de saisir la justice
Car le nouveau grand défi de la Scam – comme tout le monde de la culture, de l’audiovisuel et de la création – est bien l’IA. Et la Scam a déjà prévenu que « si cela s’avère nécessaire, elle n’hésitera pas à faire appel à la justice comme d’autres OGC l’ont fait en Europe ». Pour l’heure, en Europe, seule la Gema en Allemagne – l’équivalent en taille de la Sacem en France (1) – a remporté une bataille judiciaire contre OpenAI (ChatGPT). Or, maintenant que la proposition de loi instituant une « présomption d’utilisation des contenus culturels par les systèmes d’intelligence artificielle » (2), a été renvoyée aux calendes grecques avant même d’avoir été examinée le 11 juin 2026, la Scam pourrait mettre sa menace judiciaire à exécution. Contacté sur ce point par Edition Multimédi@, le directeur général de la Société civile des auteurs multimédia, Hervé Rony, ne nous a pas répondu.
Surtout que cette proposition de loi « Présomption » était (suite)

Libre accès à WhatsApp pour les assistants d’IA concurrents de Meta AI : « mesures conservatoires »

Ce n’est que la deuxième fois depuis l’affaire « Broadcom » en 2019 que la Commission européenne impose des « mesures conservatoires » en matière de concurrence. Cette fois elles s’imposent à Meta Platforms pour ouvrir WhatsApp aux concurrents IA de Meta AI. L’enquête sur le fond se poursuit.

Les mesures conservatoires prises à l’encontre de Meta Platforms sont exceptionnelles : « Il est vrai que nous n’utilisons pas ces pouvoirs très souvent. La dernière fois remonte à 2019. Lorsque nous [y] recourons, nous veillons à ce qu’elles soient nécessaires et à ne pas imposer de charge disproportionnée. Mais lorsqu’il s’avère indispensable d’y avoir recours, comme c’est le cas en l’espèce [envers Meta Platforms], nous le faisons. […] Les mesures adoptées aujourd’hui resteront en vigueur jusqu’au terme de notre enquête ou, au plus tard, jusqu’en juin 2029, soit dans trois ans », a précisé le 9 juin 2026 à Bruxelles Teresa Ribera (photo), vice-présidente exécutive de la Commission européenne, en charge de la transition propre, juste et compétitive.
Poke, Luzia, Agentik et OpenAI contre Meta
Rarement utilisées par Bruxelles, les « interim measures » (mesures conservatoires) consistent pour Meta Platforms à préserver le libre accès à WhatsApp pour les assistants d’IA concurrents (1). A l’origine de cette affaire, qui se poursuit au fond, se trouvent trois entreprises concurrentes de Meta AI : la start-up américaine The Interaction Company qui édite l’assistant d’IA Poke, la start-up espagnole Luzia qui est basée à Madrid, et la start-up française Agentik qui développe un système d’exploitation multi-agents spécialisés (Agentik OS).
Selon les informations de Edition Multimédi@, deux d’entre elles – Poke et Luzia – ont porté plainte directement auprès de la Commission européenne contre le géant américain dont le siège dans l’UE est à Dublin, en Irlande. Tandis que la troisième – Agentik – intervient comme (suite)

Les travailleurs fantômes de l’IA : les étiqueteurs de données ne veulent plus être en esclavage

Sama est une société américaine à qui Meta, Google ou Microsoft sous-traitent l’étiquetage de quantités de données (images, vidéos, textes, audios, …) pour le bon fonctionnement de leurs IA génératives. En avril 2026, elle a licencié plus de 1.100 d’employés au Kenya. Un métier précaire méconnu.

Sama (ex-Samasource Impact Sourcing) ne vous dit rien. C’est normal. Cette entreprise américaine – dont le siège social est situé dans la Silicon Valley, à San Francisco depuis sa création en 2008 – prospère dans l’ombre des Gafam et plus encore des nouvelles Big Tech de l’IA. Il s’agit d’un sous-traitant majeur dans le numérique et l’intelligence artificielle, qui emploie des milliers d’« étiqueteurs de données » (ou data labelers en anglais). Ce sont les « petites mains » chargées d’étiqueter des milliers, des millions voire des milliards de données brutes (images, textes, vidéos, sons, etc.).

« Histoire conflictuelle » de Sama (Ecofin)
Leur labeur est indispensable pour donner à ces monceaux de données du sens, afin que les modèles de langage des IA puissent les exploiter et répondre aux requêtes de millions d’utilisateurs du monde entier de façon plus pertinente. Ce métier dédié à l’annotation de data s’est développé à vitesse grand-V à travers la planète, notamment en Afrique et en Asie, souvent en exploitant ces travailleurs précaires et mal payés, victimes d’un nouveau « colonialisme numérique », voire d’un nouvel « esclavagisme moderne ». La société Sama que dirige Wendy Gonzalez (photo) se défend, elle, d’exploiter ses salariés et affirme leur accorder salaires décents et avantages sociaux (couverture médicale, congés payés, indemnités maladie, …).
Pour autant, l’entreprise – active principalement en Afrique de l’Est, avec son centre de Nairobi au Kenya comme plaque tournante – a annoncé le 16 avril 2026 le licenciement de 1.108 employés dans la capitale kényane en respectant l’Employment Act de ce pays (1). Et ce, a-t-elle justifié, à la suite de la fin d’un important contrat avec Meta Platforms lié à l’annotation de données pour Meta AI et anciennement à la modération de contenu. Les implantations de Sama en (suite)